작년 10월 AWS 버지니아 리전 장애 때 배달 앱이 멈추고 거래소가 멈췄습니다. 15시간, 60개국, 3,500개 이상 기업이 영향을 받았습니다. 올해 2월에는 Cloudflare 쪽에서도 장애가 있었고요.
이런 일이 반복되면 대개 "왜 이중화를 안 했나"는 얘기가 나오는데, 실제로는 이중화를 해둔 곳도 같이 멈췄습니다. 2026년 기준 전 세계 기업의 82%가 멀티클라우드를 운영하는데도요. 왜 그런지 정리해봤습니다.
장애가 퍼지는 구조

대형 클라우드 장애는 대개 비슷한 경로를 밟습니다. 설정 변경 같은 작은 작업에서 시작해서, 다른 서비스들이 기반으로 삼는 핵심 기능이 먼저 멈추고, 그 위에 올라간 수천 개 서비스가 연쇄적으로 정지합니다.
여기서 핵심은 "기반 기능"입니다. DNS, 인증, 메타데이터 저장소 같은 것들요. 서비스 하나가 죽는 것과 모든 서비스가 참조하는 기능이 죽는 건 파급력이 완전히 다릅니다.
인증이 진짜 급소다
개인적으로 가장 인상 깊었던 지적은 클라우드 장애의 실질적 피해 지점이 신원(identity)이라는 분석이었습니다.
요즘 인증은 아이디와 비밀번호를 대조하는 수준이 아닙니다. 4일차에 다룬 패스키 같은 방식이 퍼지면서, 한 번의 인증 요청 뒤에 복잡한 연쇄가 돌아갑니다. 토큰 발급 시점뿐 아니라 API 접근마다 권한 검사가 반복되고, 그 과정에 데이터스토어와 정책 엔진, 토큰 저장소, 외부 서비스가 얽힙니다.
이 중 하나만 멈춰도 접근이 즉시 차단됩니다. 애플리케이션 서버가 멀쩡하고 DB가 살아 있어도, 사용자가 로그인을 못 하면 서비스는 죽은 것과 같습니다.
그래서 애플리케이션 계층을 아무리 이중화해도 인증이 한 곳에 묶여 있으면 복원력이 없습니다. 이중화 대상 목록을 만들 때 인증을 애플리케이션과 같은 급으로 다루는지가 실질적인 차이를 만듭니다.
멀티클라우드가 작동하지 않는 이유
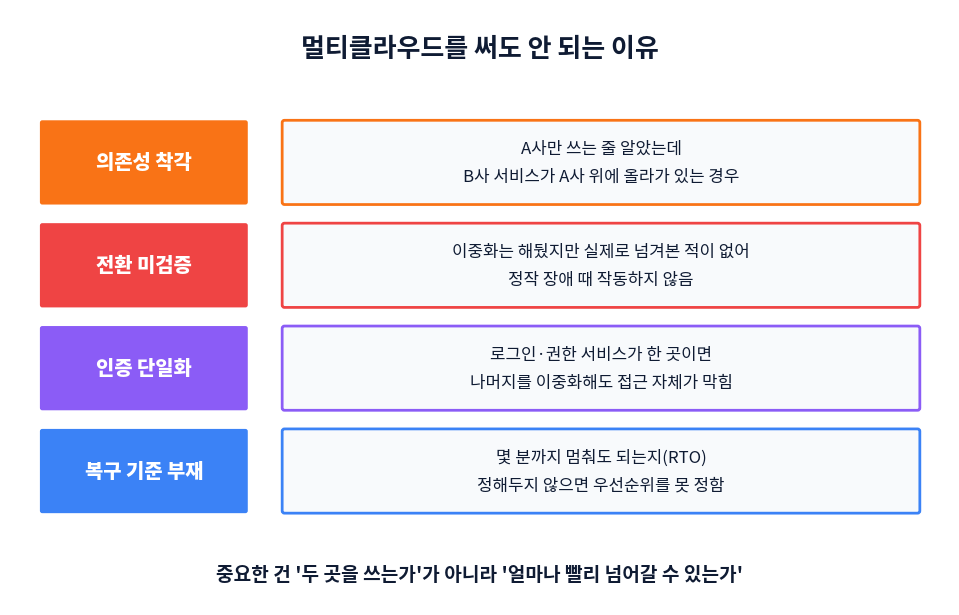
의존성 착각. A사와 B사를 함께 쓴다고 생각했는데, B사 서비스가 실은 A사 인프라 위에서 돌아가는 경우가 있습니다. SaaS를 여러 개 조합하면 그 아래 계층이 어디로 수렴하는지 파악하기 어렵습니다. 20일차 공급망 글에서 다룬 문제와 구조가 같습니다.
전환 미검증. 이중화 구성은 해뒀지만 실제로 트래픽을 넘겨본 적이 없는 경우가 많습니다. DNS TTL이 길거나 페일오버 스크립트가 오래돼 동작하지 않거나, 대기 환경의 설정이 운영과 어긋나 있거나. 검증하지 않은 이중화는 이중화가 아니라는 말이 과장이 아닙니다.
복구 기준 부재. RTO(얼마나 빨리 복구할지)와 RPO(데이터를 얼마까지 잃어도 되는지)를 정하지 않으면 장애 시에 우선순위를 정할 수 없습니다. 모든 서비스를 동등하게 복구하려다 아무것도 제대로 못 살리는 상황이 됩니다. 결제는 5분, 알림은 1시간 같은 등급 구분이 먼저 있어야 합니다.
대응 자동화라는 흐름
업계 쪽 움직임을 보면 장애 대응 자체를 자동화하는 방향으로 가고 있습니다. 감지·판단·실행·검증·개선 다섯 단계를 하나의 폐쇄 루프로 묶어서, 이상 징후를 잡으면 AI가 분석하고 이전 안정 버전으로 자동 복구한 뒤 정상화를 확인하고 기록까지 남기는 식입니다. 평균 복구 시간(MTTR)을 절반까지 줄일 수 있다는 얘기가 나옵니다.
방향은 납득이 갑니다. 장애 대응에서 시간을 가장 많이 잡아먹는 게 여러 화면과 기록을 오가며 원인을 찾는 구간이고, 담당자 호출 누락이나 수동 명령 실수도 여기서 나오니까요.
다만 자동 복구는 잘못 작동하면 장애를 키우기도 합니다. 자동화 범위를 어디까지 둘지, 사람 승인을 어느 지점에 넣을지가 결국 설계 판단으로 남습니다.
프론트엔드 관점에서
백엔드 이야기처럼 보이지만 화면 쪽에서도 할 일이 있습니다.
외부 의존성이 죽었을 때 화면이 무한 로딩에 걸리는지, 아니면 상태를 알려주는지. 타임아웃을 설정해두지 않으면 사용자는 자기 네트워크 문제라고 생각하며 계속 새로고침을 누릅니다. 그 재시도가 복구 중인 서버에 부하를 더하기도 합니다.
부분 장애 시 기능을 단계적으로 줄이는 설계도 의미가 있습니다. 추천 API가 죽었다고 상품 목록 전체가 안 보일 필요는 없으니까요. 비핵심 기능의 실패를 격리하는 것만으로 체감 장애 범위가 크게 줄어듭니다.
정리
클라우드를 쓰는 건 이제 선택이 아니고, 대형 장애도 없어지지 않을 겁니다. 그래서 질문이 "장애를 막을 수 있나"에서 "장애가 났을 때 얼마나 빨리 돌아오나"로 옮겨갔습니다.
체크할 건 세 개로 줄여볼 수 있습니다. 우리 서비스의 의존성이 실제로 어디로 수렴하는지 알고 있는가, 페일오버를 최근에 실제로 테스트해봤는가, 서비스별 복구 목표 시간이 문서로 있는가. 셋 다 "예"가 아니면 이중화 구성 자체는 별 의미가 없습니다.
'IT' 카테고리의 다른 글
| 로봇이 달라진 건 몸이 아니라 두뇌다 (0) | 2026.09.23 |
|---|---|
| 접근성은 배려가 아니라 요건이다 (0) | 2026.09.22 |
| 학습은 합법, 수집은 불법일 수 있다 - AI 저작권 정리 (0) | 2026.09.22 |
| 계정은 상속되지 않는다, 데이터도 마찬가지다 (0) | 2026.09.21 |
| UI 설계가 규제 대상이 됐다 - 다크패턴 6유형 정리 (0) | 2026.09.21 |