"AI가 남의 글로 학습하는 건 저작권 침해인가." 이 질문에 대한 답이 왜 이렇게 엇갈리는지 궁금했습니다. 어떤 판결은 합법이라 하고 어떤 판결은 침해라 하고, 심지어 같은 회사가 한 소송에서 이기고 지기도 하니까요.
찾아보니 질문 자체를 쪼개야 하는 문제였습니다.
세 단계로 나눠야 한다
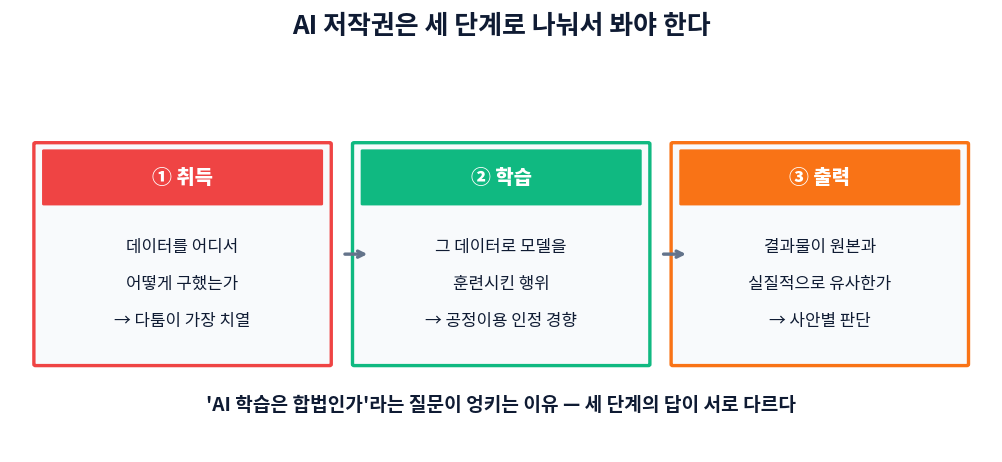
미국 정부가 올해 9월 OpenAI 관련 통합 소송에 제출한 의견서가 이 구분을 명확하게 했습니다. 언어모델 개발을 취득·학습·출력 세 단계로 나눈 뒤, 각 단계가 저작권법상 서로 다른 질문을 낳는다고 정리하고 학습 단계만 다루겠다고 명시했습니다.
취득은 데이터를 어디서 어떻게 구했느냐입니다. 책을 사서 스캔했는지, 해적판 사이트에서 내려받았는지. 지금 다툼이 가장 치열한 지점입니다.
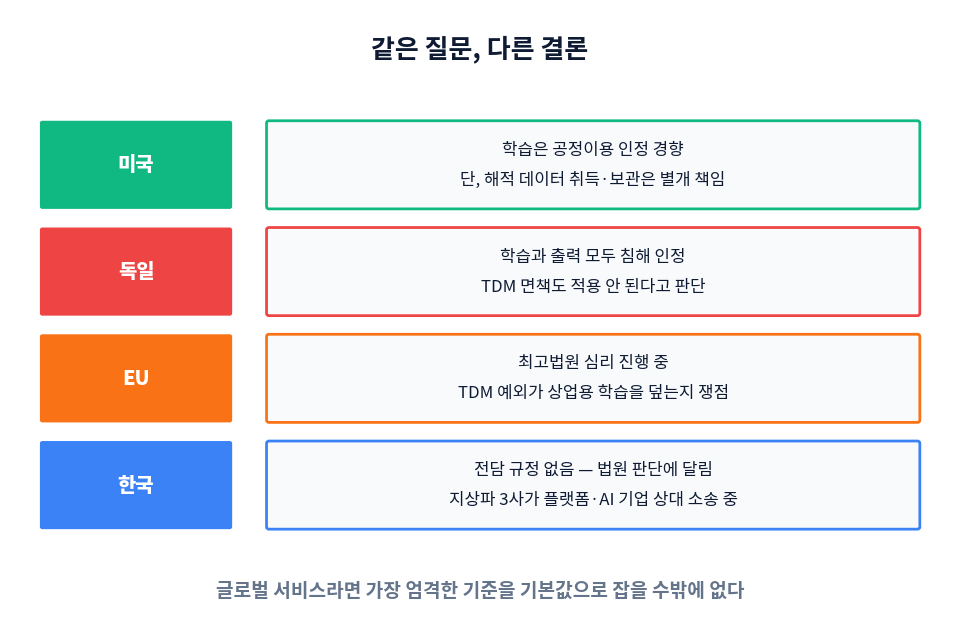
학습은 그 데이터로 모델을 훈련시킨 행위 자체입니다. 미국 법원은 이걸 변형적 이용으로 보고 공정이용을 인정하는 경향을 보였습니다.
출력은 결과물이 원본과 실질적으로 유사한지입니다. 사안별로 판단됩니다.
이 구분을 알면 앞서 말한 모순이 풀립니다. Anthropic 사건에서 법원은 학습 자체는 공정이용으로 인정했지만, 해적판 데이터를 내려받아 보관한 행위는 별개로 책임을 인정했습니다. 결국 15억 달러 규모 합의로 이어졌고요. 학습은 이기고 취득에서 진 겁니다.
메타를 상대로 한 출판사들의 소송도 초점이 같습니다. "Llama가 우리 책으로 학습했다"가 아니라 "그 책들을 어디서 어떻게 손에 넣었나"가 쟁점이었습니다. 토렌트로 대량 내려받고 추적을 피하려 했다는 주장이요. 피고석에 선 게 모델이 아니라 취득 방식이라는 표현이 정확합니다.
나라마다 결론이 다르다
여기서 문제가 복잡해집니다.
독일 뮌헨지방법원은 지난해 11월 GEMA와 OpenAI 사건에서 학습과 출력 과정의 가사 이용이 복제권과 공중이용제공권 침해에 해당하고, 텍스트·데이터 마이닝(TDM) 면책 규정도 적용되지 않는다고 판단했습니다. 미국 판결들과 결론이 정반대입니다.
EU 최고법원은 올해 3월 이 문제를 처음 심리했습니다. 쟁점은 EU 저작권 지침의 TDM 예외가 상업용 LLM 학습까지 덮느냐인데, 아직 판결은 나오지 않았습니다. 주목할 건 일부 회원국이 "EU 밖에서 학습했더라도 EU 안에서 상업화하면 EU 저작권법이 적용된다"는 역외 해석을 지지했다는 점입니다.
국내는 전담 규정이 없습니다. 2026년 1월 시행된 AI 기본법도 학습 데이터와 저작권 공백을 명시적으로 메우지 못한 상태라, 당분간 법원 판단에 달려 있습니다. 실제 소송도 진행 중입니다. 지상파 3사가 뉴스 데이터의 AI 학습 이용을 문제 삼아 국내 플랫폼을 상대로, 이후 OpenAI를 상대로도 소송을 제기했습니다.
실질적 변화: 출처 증명이 자산이 됐다
판결 방향과 별개로 확실해진 흐름이 하나 있습니다. 데이터의 출처를 증명할 수 있느냐가 실질적인 요건이 됐다는 것입니다.
음악 출판사들이 Anthropic을 상대로 낸 소송의 구제 목록이 상징적입니다. 손해배상과 함께 어떤 저작물로 학습했는지 특정하고 수집·처리 방법을 공개하라는 회계 보고 요구가 들어 있습니다. 저작권관리정보(CMI) 제거 여부도 별도 쟁점으로 다뤄집니다. Anthropic은 이 주장을 받아들이지 않고 법정에서 방어하겠다는 입장입니다.
주목할 건 출처를 묻는 주체가 법원에서 규제기관과 구매자로 넓어졌다는 점입니다. EU는 8월부터 학습 데이터 공개 의무에 벌금을 붙였고, 모델을 도입하는 기업은 성능 벤치마크보다 데이터 출처 서류를 먼저 요구하는 흐름이 생겼습니다.
즉 소송에서 이기느냐와 무관하게, 데이터 계보를 문서화하지 못하면 시장에 진입하기 어려워지는 구조입니다.
개발자 입장에서
당장 실무에 닿는 부분을 정리하면 이렇습니다.
모델을 쓸 때. 어떤 데이터로 학습됐는지, 상업적 이용이 허용되는지, 출력물 저작권은 어떻게 다뤄지는지가 라이선스마다 다릅니다. 특히 "연구용"이라는 조건이 붙은 모델을 제품에 넣는 건 위험합니다.
데이터를 모을 때. 크롤링으로 학습 데이터를 만든다면 robots.txt와 이용약관을 확인해야 합니다. 20일차 공급망 글에서 다룬 것처럼, 나중에 "어디서 왔는지 모르겠다"가 되면 대응할 방법이 없습니다. 수집 시점의 출처와 조건을 기록해두는 게 핵심입니다.
출력물을 쓸 때. AI가 생성한 이미지나 코드가 특정 저작물과 유사하게 나오는 경우가 있습니다. 상업적으로 쓸 거라면 검토가 필요합니다.
정리
이 문제에 명쾌한 답은 아직 없습니다. 같은 행위에 대해 미국과 독일 법원이 다른 결론을 냈고, EU는 심리 중이고, 국내는 규정 자체가 없습니다.
다만 "AI 학습은 합법인가"라는 질문 대신 "어느 단계를 말하는가"를 먼저 묻는 습관이 이 논쟁을 읽는 데 도움이 됩니다. 그리고 실무 차원에서는 결론을 기다릴 필요 없이 출처 기록부터 챙기는 게 합리적이라고 봅니다. 어느 쪽으로 정리되든 그건 요구될 테니까요.
'IT' 카테고리의 다른 글
| 접근성은 배려가 아니라 요건이다 (0) | 2026.09.22 |
|---|---|
| 멀티클라우드는 정답이 아니었다 (0) | 2026.09.22 |
| 계정은 상속되지 않는다, 데이터도 마찬가지다 (0) | 2026.09.21 |
| UI 설계가 규제 대상이 됐다 - 다크패턴 6유형 정리 (0) | 2026.09.21 |
| 신분증이 화면 속으로 들어오면 생기는 일 (0) | 2026.09.21 |