"소버린 AI"라는 말이 자주 들립니다. 정부가 독자 AI 파운데이션 모델 프로젝트를 진행 중이고, 5개 팀이 각자 모델을 개발해 단계 평가를 받고 있습니다.
그런데 이 논의가 자주 "우리도 GPT 같은 걸 만들자"로 단순화됩니다. 실제로는 그보다 층위가 많은 문제라 정리해봤습니다.
네 가지 주권
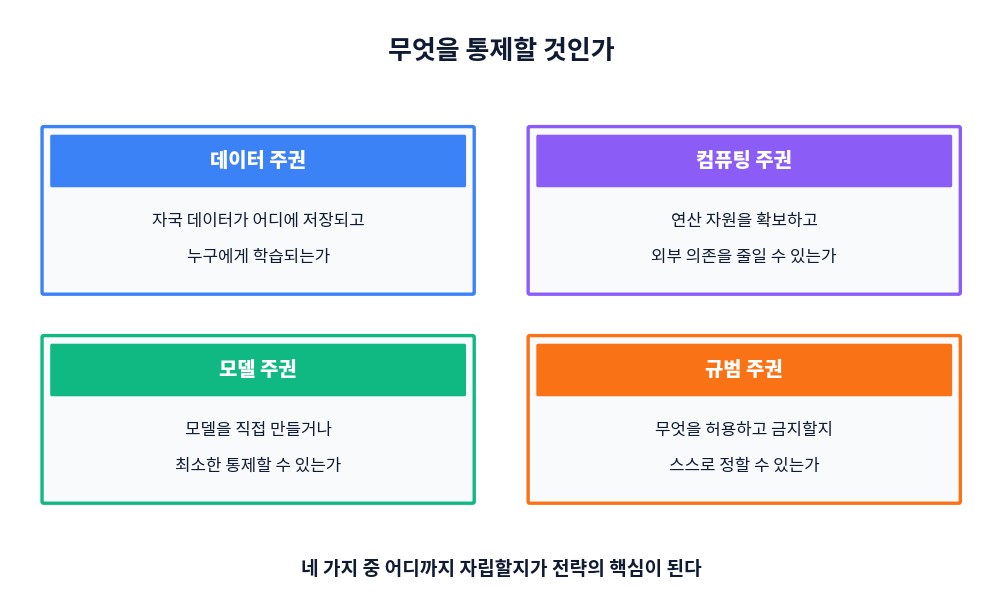
소버린 AI는 보통 네 가지 요소로 설명됩니다. 데이터, 컴퓨팅, 모델·소프트웨어, 규범·윤리 주권요.
개념적으로는 포함 관계로 정리됩니다. 국가 주권 안에 디지털 주권이 있고, 그 안에 AI 주권이 있고, 자체 파운데이션 모델은 그걸 실현하는 수단 중 하나입니다. 모델을 만드는 게 목표가 아니라 수단이라는 거죠.
이 구분이 중요한 이유가 있습니다. 네 가지를 전부 자립하는 건 현실적으로 어렵습니다. 연산 자원만 해도 GPU 공급망이 사실상 소수 기업에 묶여 있으니까요. 그래서 어느 층위를 통제하고 어디서 협력할지를 정하는 게 실제 전략이 됩니다.
43일차 지도 반출 글에서 데이터가 어느 관할에 있어야 하는지를 다뤘는데, 같은 질문이 AI 전반으로 확장된 셈입니다.
자강과 협력 사이
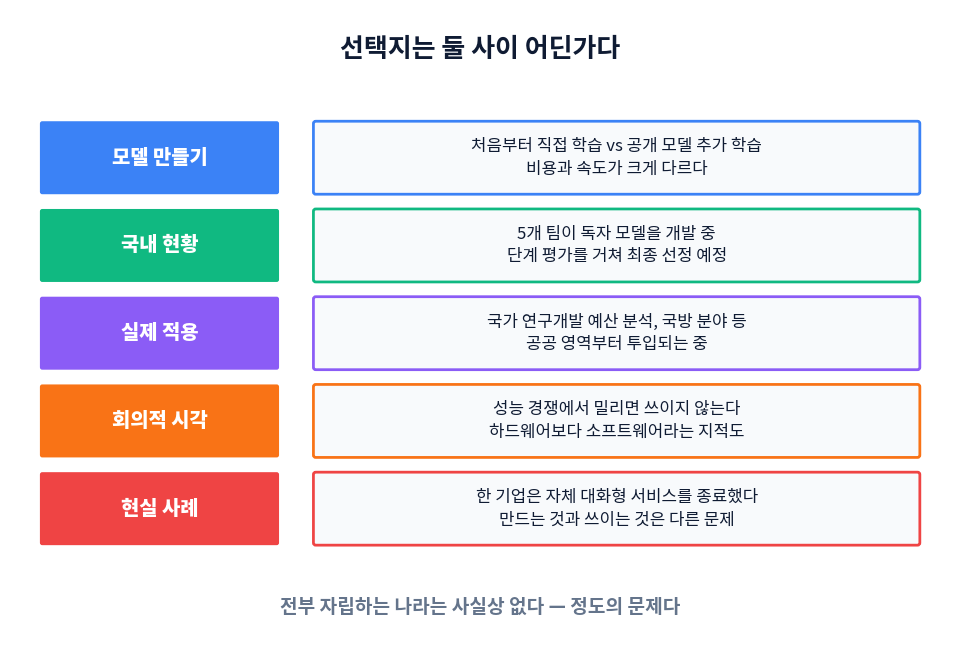
모델을 만드는 방법도 두 갈래입니다.
**처음부터 직접 학습(from scratch)**은 데이터 구성과 구조를 전부 통제할 수 있지만 비용과 시간이 큽니다. **공개 모델 기반 추가 학습(CPT)**은 훨씬 빠르고 저렴하지만 기반 모델의 특성을 물려받습니다.
전자가 더 "주권적"으로 보이는데, 따져볼 지점이 있습니다. 공개 가중치 모델을 받아 자국 데이터로 학습하고 자국 인프라에서 운영한다면, 데이터·컴퓨팅·규범 주권은 확보됩니다. 모델 주권만 부분적인 거죠. 반대로 자체 모델을 만들었어도 해외 클라우드에서 돌린다면 컴퓨팅 주권은 없습니다.
즉 "직접 만들었나"보다 "어느 층위에서 통제권이 있나"가 실질적인 질문입니다.
국내 진행 상황
정부 프로젝트에는 네이버클라우드, 업스테이지, SK텔레콤, NC AI, LG AI연구원 등이 참여 중이고, GPU 지원과 함께 단계 평가를 거쳐 최종 선정이 이뤄질 예정입니다.
공공 적용도 시작됐습니다. 업스테이지 모델이 국가 연구개발 예산 배분·조정 업무에 투입된 게 독자 모델의 공공 AX 첫 사례로 소개됐고, SK텔레콤은 국방 분야 활용 협약을 맺었습니다.
공공부터 들어가는 건 합리적입니다. 보안 요구가 높아 해외 서비스를 쓰기 어렵고, 발주처가 명확해서 수요가 보장되니까요. 다만 이게 한계이기도 합니다.
만드는 것과 쓰이는 것
여기가 이 글에서 가장 짚고 싶은 부분입니다.
나무위키 서술에도 나오는 지적인데, 소버린 AI는 사용자 수가 적고 성능이 한정적인 경우가 많습니다. 최대 고객이 정부·공공기관이나 대기업이라 엄격한 윤리 필터링이 강제되는 경우도 있고요.
그리고 시사적인 사실이 하나 있습니다. 2026년 4월 네이버가 대화형 AI 클로바X와 검색 AI 서비스의 B2C 제공을 종료했습니다. 소버린 AI 개념을 처음 제시한 기업으로 거론되는 곳인데도요.
이건 기술력 문제라기보다 소비자 시장에서 글로벌 모델과 정면 경쟁하는 게 어렵다는 현실로 보입니다. 성능 차이도 있지만, 사용자는 익숙한 서비스를 바꿀 이유가 있어야 옮기니까요.
그래서 차별점이 어디서 나오느냐가 관건입니다. 한국어 품질이나 문화 맥락 이해는 글로벌 모델도 빠르게 따라오고 있습니다. 반면 데이터가 밖으로 나가면 안 되는 영역(국방, 의료, 금융, 공공)은 성능이 조금 떨어져도 선택될 이유가 있습니다.
업계에서는 "인프라·플랫폼형 중견국 모델"이라는 표현도 쓰입니다. 반도체와 데이터센터, 제조 AI를 결합해 전면 경쟁 대신 강점 영역에 집중하자는 구상이죠.
회의적 시각도 있다
균형을 위해 반대 논리도 짚으면, 업계에서 엇갈린 전망이 나옵니다.
"GPU보다 메모리가 중요해지고 메모리 안에 GPU 기능이 통합되는 시대가 올 테니 하드웨어보다 소프트웨어와 알고리즘에 투자해야 한다"는 의견이 대표적입니다. 대규모 GPU 확보에 자원을 쏟는 게 최선이냐는 문제 제기죠.
44일차 HBM 글에서 병목이 연산에서 메모리로 옮겨갔다는 얘기를 했는데, 그 흐름을 전제로 하면 투자 우선순위가 달라질 수 있다는 논리입니다.
반대편에서는 기반 역량 없이 응용만 하면 결국 종속이 심화된다고 봅니다. 어느 쪽이 맞는지는 몇 년 뒤에야 판가름 날 문제고, 지금은 양쪽 다 근거가 있습니다.
정리
소버린 AI를 "우리도 큰 모델 만들자"로 읽으면 성능 비교로 논의가 흘러갑니다. 그런데 실제 쟁점은 통제권을 어느 층위까지 확보할 것인가, 그리고 확보한 역량이 실제로 쓰이는가입니다.
모델이 만들어지는 것과 사람들이 쓰는 것 사이에는 꽤 먼 거리가 있고, 그 거리를 어떻게 좁히느냐가 이 프로젝트의 성패를 가를 것 같습니다.
'IT' 카테고리의 다른 글
| 사람이 읽을 수 없는 유일한 링크 (0) | 2026.10.07 |
|---|---|
| 항목이 늘어난 게 과학 발전 때문만은 아니다 (0) | 2026.10.06 |
| 텍스트를 거치지 않자 대화가 가능해졌다 (0) | 2026.10.06 |
| 충전 기술이 아니라 인증 체계 이야기다 (0) | 2026.10.06 |
| 고장나서가 아니라 지원이 끊겨서 버린다 (0) | 2026.10.06 |