AI 스피커는 10여 년 전 크게 주목받았다가 조용히 사라진 카테고리입니다. 아마존 에코, 구글 홈, 애플 홈팟, 국내에서는 네이버 클로바와 카카오 미니까지 나왔는데 대부분 기대에 못 미쳤습니다.
그런데 최근 다시 움직임이 보입니다. LG전자가 마이크로소프트와 함께 음성 대 음성 AI를 스마트홈 허브에 적용하겠다고 발표했고, 오픈AI는 화면 없는 이동형 스피커를 준비 중이라고 알려졌습니다.
같은 카테고리가 다시 시도되는 이유는 인식 기술이 아니라 처리 구조가 바뀌었기 때문입니다.
무엇이 문제였나
예전 음성 비서가 안 쓰인 이유를 "말을 잘 못 알아들어서"로 기억하기 쉬운데, 정확하지 않습니다. 음성 인식 자체는 꽤 정확했습니다.
문제는 그다음이었습니다. 인식한 문장을 이해하고 적절히 실행하는 부분이요. 미리 정의된 명령 패턴에 맞으면 작동하고, 조금만 벗어나면 "죄송합니다, 이해하지 못했어요"가 나왔습니다. 결국 타이머, 날씨, 음악 재생 정도로 쓰임이 수렴했죠.
보도를 보면 아마존도 알렉사 개발이 한동안 정체됐다가 LLM 기반으로 다시 만드는 쪽으로 방향을 틀었습니다.
파이프라인이 달라졌다
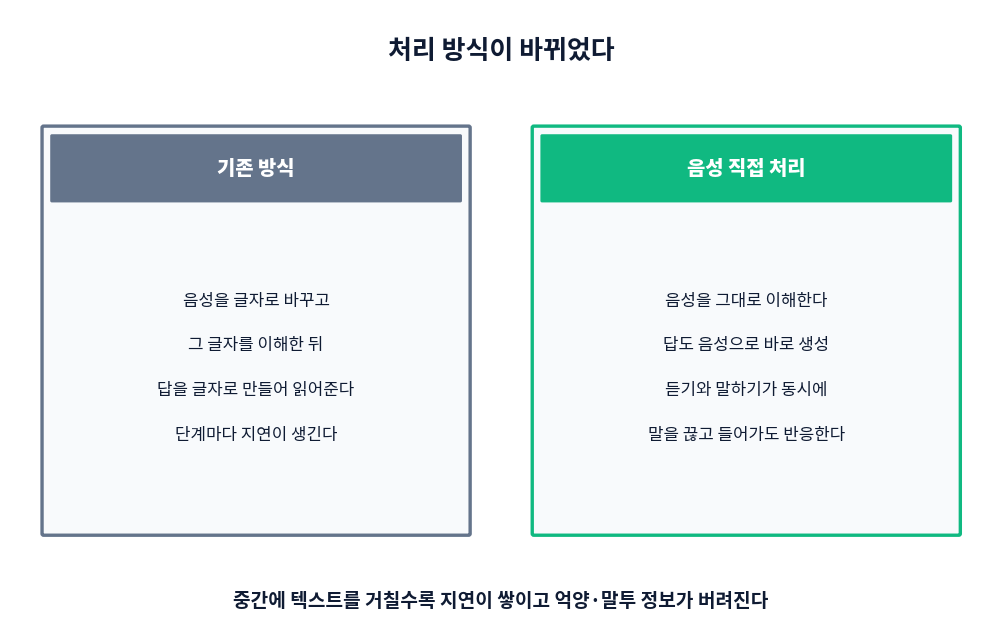
기존 구조는 세 단계였습니다. 음성을 텍스트로 변환(STT) → 텍스트를 이해하고 답변 생성 → 텍스트를 음성으로 변환(TTS).
이 구조에는 두 가지 손실이 있습니다.
지연이 쌓입니다. 각 단계마다 처리 시간이 붙고, 보통은 문장이 끝나야 다음 단계로 넘어갑니다. 그래서 말을 마치고 한 박자 기다려야 답이 옵니다.
정보가 버려집니다. 음성을 텍스트로 바꾸는 순간 억양, 말의 속도, 망설임 같은 신호가 사라집니다. "괜찮아요"가 체념인지 수락인지는 텍스트로는 구분되지 않습니다.
음성을 직접 다루는 방식은 이 중간 변환을 줄입니다. 듣기와 말하기를 동시에 수행하면서 대화 도중 반응을 조절할 수 있게 되고요.
여기서 나오는 게 끼어들기입니다. LG전자 시연에서 소개된 기능인데, 사용자가 답변이 끝나기 전에 새 질문을 하면 기존 응답을 중단하고 의도를 다시 파악합니다. 사람끼리 대화할 때는 당연한 일인데, 기존 구조에서는 구현이 까다로웠습니다. 답변 생성이 이미 끝난 상태에서 재생만 하고 있었으니까요.
실행까지 이어지는 게 핵심
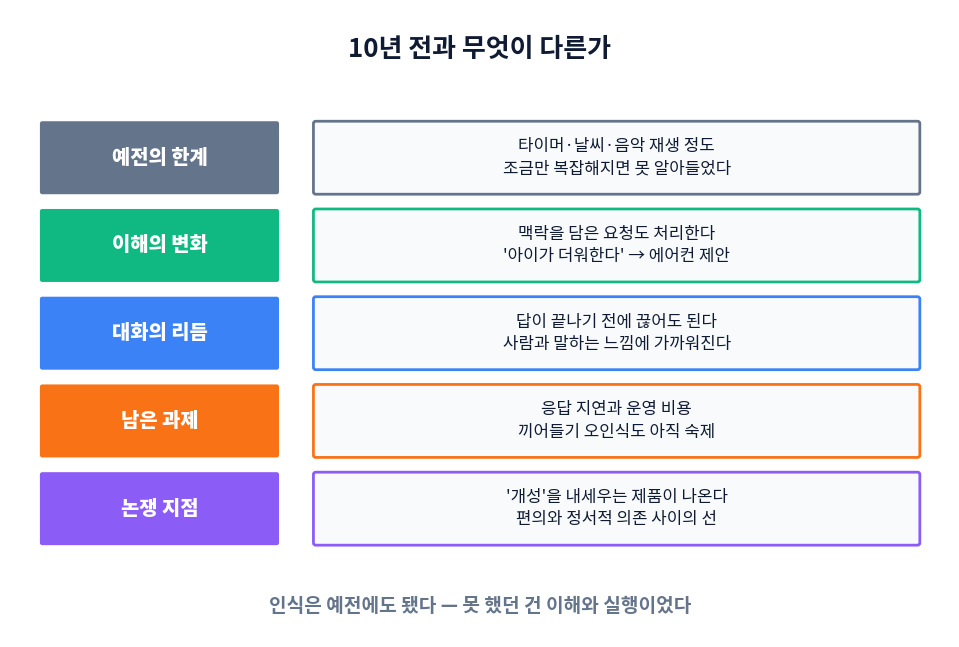
LG 시연에서 인상적인 대목이 있습니다. 사용자가 "아이가 더워하는 것 같다"고 말하자 시스템이 "에어컨을 켜드릴까요"라고 제안하고, 동의하자 작동시켰다는 부분입니다.
이게 기존 방식과 다른 지점입니다. "에어컨 켜줘"는 명령이지만 "아이가 더워한다"는 상황 설명입니다. 후자를 받아서 적절한 행동을 제안하려면 맥락 해석이 필요합니다.
그리고 해석만으로는 부족합니다. 실제로 기기를 제어할 수 있어야 하는데, 여기서 33일차 매터 글에서 다룬 상호운용성이 전제가 됩니다. 어느 브랜드 기기든 제어할 수 있어야 "AI가 집을 관리한다"가 성립하니까요. 음성 AI와 기기 표준이 같은 시기에 성숙하는 건 우연이 아닌 것 같습니다.
남은 기술 과제
지연시간. 사람이 대화에서 불편을 느끼지 않는 응답 간격은 짧습니다. 클라우드를 왕복하면 그 시간을 맞추기 어렵습니다. 5일차 온디바이스 AI 글에서 다룬 것처럼 간단한 처리는 기기에서 하고 복잡한 건 서버로 보내는 하이브리드가 현실적인 답으로 보입니다.
비용. 음성 대화는 턴이 많습니다. 최근 연구 중에는 긴 세션에서 턴당 비용을 크게 줄이는 컨텍스트 관리 기법을 다룬 것도 있습니다. 2일차 토큰맥싱, 11일차 AI 전력 글에서 본 것처럼 비용 구조가 서비스 설계를 제약합니다.
끼어들기 오인식. 주변 소음이나 패킷 손실을 발화로 잘못 인식하면 멀쩡히 답하다가 끊깁니다. 관련 연구에서 이 오인율을 줄이는 걸 성과 지표로 삼는 것도 그래서고요.
논쟁이 될 지점
오픈AI가 준비 중인 기기에 대한 보도에서 눈에 띄는 대목이 있습니다. 핵심 경쟁력을 **'개성'**으로 본다는 것, 명령에 반응하는 사물이 아니라 살아 있는 존재처럼 느껴지게 설계한다는 것이요.
기술적으로는 자연스러운 방향입니다. 일관된 말투와 성격이 있으면 쓰기 편하니까요. LG도 에이전트 페르소나를 적용해 일관된 경험을 주겠다고 밝혔습니다.
다만 이 방향에는 생각해볼 지점이 있습니다. 도구가 동반자로 포지셔닝되면 정서적 의존 문제가 따라옵니다. 특히 혼자 지내는 시간이 긴 사용자에게는 영향이 클 수 있고요. 편의를 높이는 설계와 관계를 모방하는 설계는 구분해서 볼 필요가 있다고 생각합니다.
정리
음성 인터페이스가 다시 시도되는 건 기술 유행이 돌아서가 아니라 막혀 있던 부분이 실제로 뚫렸기 때문입니다. 이해하고 실행하는 능력, 그리고 대화의 리듬이요.
다만 10년 전에도 데모는 인상적이었습니다. 실제로 쓰이는지는 지연시간과 안정성이 일상 사용을 견딜 수준인지에 달려 있을 겁니다.
'IT' 카테고리의 다른 글
| 항목이 늘어난 게 과학 발전 때문만은 아니다 (0) | 2026.10.06 |
|---|---|
| 만드는 것과 쓰이게 하는 것은 다르다 (0) | 2026.10.06 |
| 충전 기술이 아니라 인증 체계 이야기다 (0) | 2026.10.06 |
| 고장나서가 아니라 지원이 끊겨서 버린다 (0) | 2026.10.06 |
| 문제는 장소가 아니라 정보 비대칭이다 (0) | 2026.10.05 |